Chunk optimalisering
AI leser ikke innholdet ditt som en helhet. Den vurderer det i separate tekstbiter, også kalt «chunks».

Oppdatert 5 min lesetid
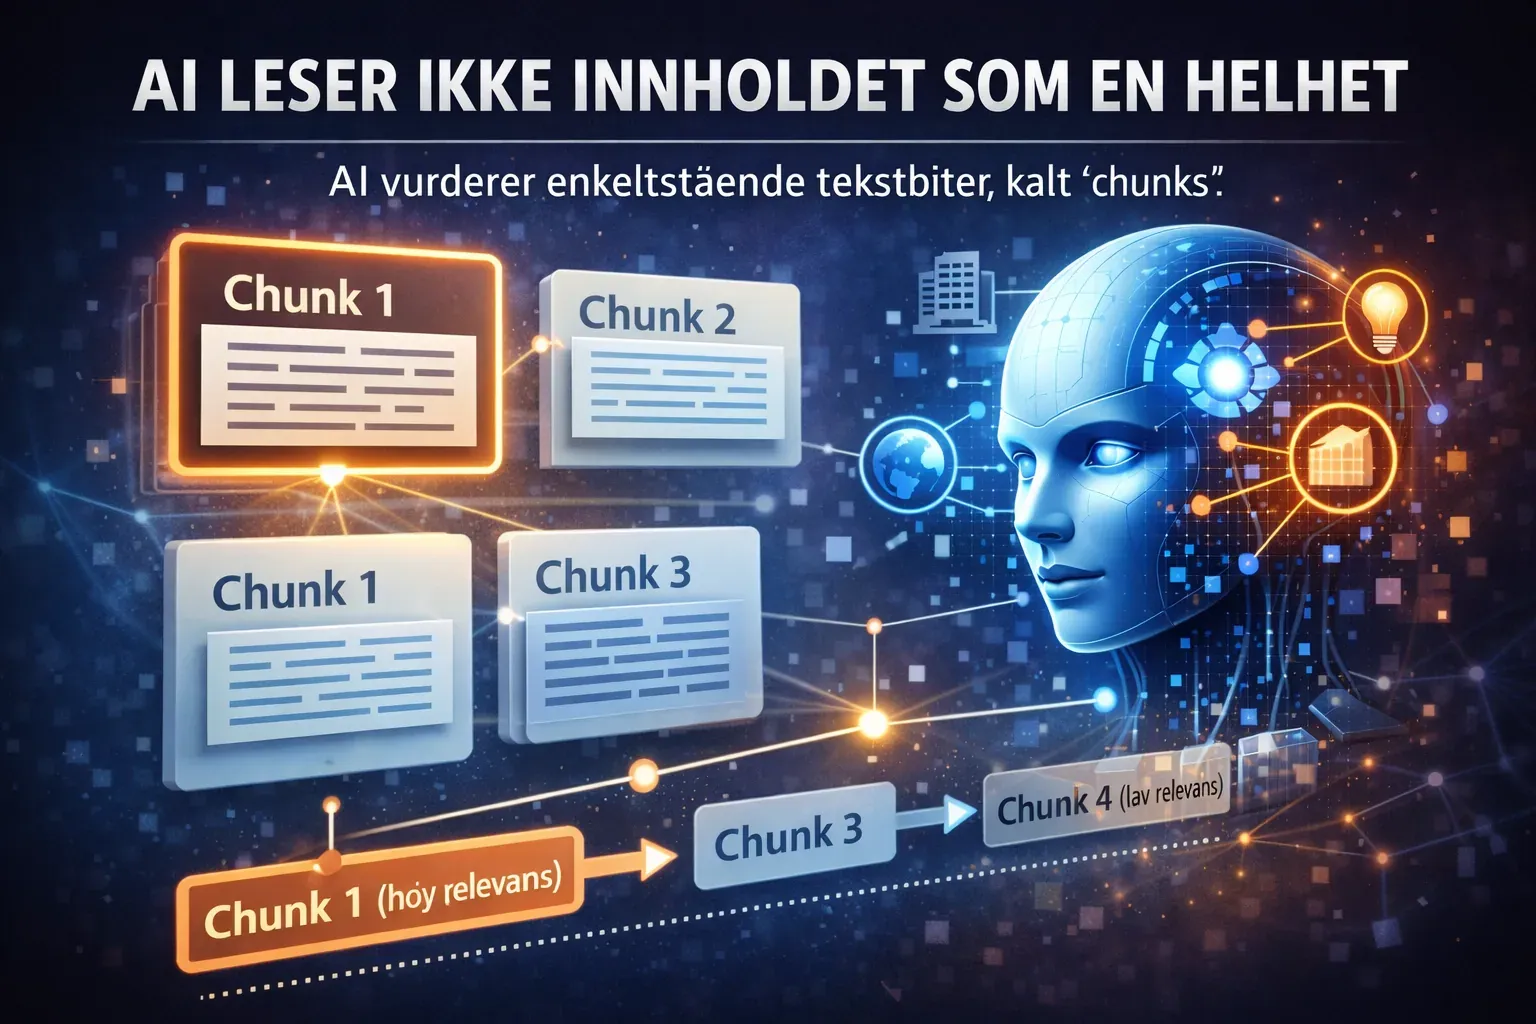
AI leser ikke innholdet ditt som en helhet. Den vurderer det i separate tekstbiter, også kalt «ChunkEn chunk er en avgrenset tekstbit som en språkmodell henter og vurderer for seg. Modellen siterer sjelden en hel side — den siterer den chunken som best besvarer spørsmålet.Se i ordlisten».
Fra ord til objekter i AI SEO
AI leser ikke innholdet ditt som en helhet. Google AI Overviews og ChatGPT vurderer innhold i separate tekstbiter, ofte kalt chunks, og velger hvilke biter som er trygge nok å bruke som kilder. Når chunkene mangler tydelige EntitetEn entitet er en identifiserbar ting — en person, et selskap, et produkt eller et sted — som søkemotorer og språkmodeller kan knytte fakta til. Konsistent navn, kontaktinfo og profiler på tvers av kilder er det som gjør entiteten entydig.Se i ordlisten og tydelige relasjoner, faller innholdet ut av vurderingen, selv om teksten er velskrevet.
Hvor den gamle SEO antagelsen sprekker
Mye klassisk innholds SEO bygger på en implisitt idé om at helheten på siden blir vurdert. I generativt søk blir vurderingen mer fragmentert. Systemet henter et utsnitt, tolker utsnittet, og bruker utsnittet i et svar.
Konsekvensen blir enkel å observere i praksis. En side kan ha sterk autoritet og fortsatt gi lav synlighet i generative svar hvis chunkene ikke er selvstendige, presise og fulle av identifiserbare objekter. I AI Mode og AI Overviews ser Google også ut til å gjøre kildelenking mer granular, med flere kildehenvisninger inne i selve svaret, som gjør konkurransen om å være sitérbar hardere.
Definisjoner som faktisk betyr noe i 2026
Chunk er et tekstutdrag som behandles som en egen vurderingsenhet i retrieval og generering. Chunking brukes fordi modeller og embeddings har inputbegrensninger, og fordi gjenfinning fungerer bedre når tekst er brutt ned i håndterbare biter. Mange oppsett bruker 128 til 512 tokens som arbeidsområde, og overlap brukes for å unngå at sammenhenger kuttes.
Entitet er et identifiserbart objekt modellen kan holde stabilt i en representasjon. Personer, selskaper, produkter, steder, standarder, metoder og systemer er typiske entiteter. Entitetsoptimalisering betyr at du gjør disse objektene eksplisitte, konsistente og knyttet til hverandre.
Embeddings er vektorrepresentasjoner brukt til å måle semantisk nærhet mellom tekst og forespørsel, eller mellom tekstbiter. Når entiteter og relasjoner er tydelige, blir embeddingrommet mer presist og gjenfinning mer stabil.
Slik bygger generative systemer forståelse av siden din
En praktisk mentalmodell er en pipeline med fire vurderinger, der hvert steg blir dårligere når entiteter er uklare.
-
Oppdeling Tekst deles i chunks. Størrelsen varierer med verktøy og formål. Det finnes ingen magisk chunk size som passer alt, men det finnes tydelige kompromisser. Små chunks fungerer ofte godt for faktaspørsmål, større chunks kan fungere bedre når sammenheng må bevares.
-
Entitetsgjenkjenning Systemet identifiserer entiteter i chunken. Hvis du skriver uklart, bruker generiske substantiver, eller introduserer begreper uten å navngi dem, blir entitetskartet tynt.
-
Relasjonsutvinning Systemet prøver å finne relasjoner mellom entitetene. Relasjoner må ofte være eksplisitte for å bli robuste. “Google bruker Knowledge Graph til å knytte entiteter” er en relasjon. “Google og entiteter henger sammen” er mer støy enn signal.
-
Gjenfinning og SiteringEn sitering er når en AI-tjeneste oppgir kilden bak et svar, som regel med lenke. Sitering er noe annet enn omtale: du kan bli nevnt uten å bli lenket til, og lenket til uten å bli nevnt ved navn.Se i ordlisten Når en bruker spør, hentes chunks som ligner i embeddingrommet, og chunks med høy relevans og tydelig semantikk blir oftere brukt i svaret. I praksis betyr det at sitater og kildebruk skjer på chunk nivå, ikke side nivå, som du også beskriver i Chunk Relevancy RatioChunk Relevancy Ratio er forholdet mellom antall tekstbiter på en side som er relevante for et gitt spørsmål, og det totale antallet biter på siden. En lang side med lav andel taper mot en kort side med høy andel, fordi språkmodeller henter biter og ikke sider.Se i ordlisten tankegangen din. LinkedIn
Semantisk usynlighet er en konkret effekt, ikke en metafor
Når entiteter er uklare oppstår tre typiske feilbilder:
-
Tvetydighet: Apple som frukt versus Apple som selskap er klassikeren. Tvetydighet reduserer sannsynligheten for at chunken anses trygg å bruke, fordi modellen kan bomme på betydning.
-
Svakt gjenfinningssignal: Chunk uten navngitte aktører og mekanismer matcher dårligere i embeddingrommet.
-
Lav sitérbarhet: Chunk uten tall, mekanismer og klare påstander gir lite å sitere, så den taper mot chunk som har enkle, testbare utsagn.
Dette henger tett sammen med hvordan Google utvider kildehenvisninger inne i genererte svar. Når flere kilder kan lenkes i svaret, må hver kilde fortjene plassen sin med høy presisjon per tekstbit.
Innhold som kunnskapsgraf i miniatyr
En nyttig reframing er å se hver chunk som en liten kunnskapsmodul, der du må levere et minimum av struktur.
En robust chunk inneholder vanligvis:
-
minst to navngitte entiteter
-
en eksplisitt relasjon
-
en observerbar effekt eller konsekvens
-
nok kontekst til at chunken kan siteres alene
Dette er samme logikk du ser i RAGRAG (Retrieval-Augmented Generation) er når en språkmodell henter inn eksterne dokumenter før den svarer, i stedet for å svare kun fra det den er trent på. Det er denne mekanismen som gjør at ferskt innhold kan siteres.Se i ordlisten tooling og dokumentdeling, der splitting og overlap styres for å unngå at entiteter kuttes i stykker.
Egenskap og effekt som AI kan plukke rett ut
| Egenskap i chunken | Effekt i generativt søk |
|---|---|
| Navngitte entiteter som Google, OpenAI, Gemini, ChatGPT | Mer stabil tolkning og tydeligere embeddingprofil |
| Eksplisitte relasjoner som “Google bruker Knowledge Graph” | Høyere semantisk presisjon og bedre gjenfinning |
| Konkrete datapunkter som 128 til 512 tokens | Mer sitérbart materiale og tydeligere mekanisme |
| Konsistente termer som entitet, chunk, embeddings | Lavere risiko for semantisk drift mellom avsnitt |
| Autonome avsnitt som kan stå alene | Større sjanse for å bli hentet som enkeltkilde |
Hvordan vurdere egen tekst uten å late som
Kjør en hard evaluering av de første 250 til 400 ordene på en side. I generativ gjenfinning veier tidlige signaler tungt, fordi de ofte havner i de første chunkene.
Sjekkpunkter som faktisk avslører noe:
-
Første chunk nevner minst én primær entitet og minst én sekundær entitet, for eksempel Google AI Overviews og Knowledge Graph.
-
Første chunk inneholder en relasjon, for eksempel at Google bruker generering og kilder på en bestemt måte.
-
Første chunk inneholder en målbar påstand, for eksempel tokenområder som 128 til 512, eller at kildehenvisninger vises inne i svaret.
Retning videre som matcher hvordan systemene fungerer
Når chunking og entiteter blir sett som samme problem, blir neste naturlige fokus tre områder.
-
Chunk grenser og overlap, fordi entiteter som deles i to gir dårligere signal og svakere gjenfinning.
-
Entitetsdekning per side, der du kartlegger hvilke entiteter som bør være med for å dekke spørsmålene AI faktisk må svare på
-
Sitérbarhet, der du systematisk legger inn tall, mekanismer og presise relasjoner som kan plukkes ut i et svarformat
Å kartlegge egen sitérbarhet langs alle tre punktene over — chunk-grenser, entitetsdekning og sitérbarhet — er en systematisk jobb, ikke noe du gjør på magefølelse. Vil du ha den kartleggingen gjort for ditt eget domene, er det nettopp det AI SEO Analyse leverer.
Kilder
Første gang publisert på Linkedin: https://www.linkedin.com/pulse/why-chunk-relevancy-ratio-critical-focus-aeogeoai-seo-krister-ross-q2nvf/
Milvus: What is the optimal chunk size for RAG applications?
https://www.thekeyword.co/news/google-adds-more-source-links-in-ai-mode-responses
Takk — dette hjelper meg med å gjøre artikkelen bedre.
Ordforklaringer
Begrepene som brukes i denne artikkelen.
- Chunk
- En chunk er en avgrenset tekstbit som en språkmodell henter og vurderer for seg. Modellen siterer sjelden en hel side — den siterer den chunken som best besvarer spørsmålet.
- Entitet
- En entitet er en identifiserbar ting — en person, et selskap, et produkt eller et sted — som søkemotorer og språkmodeller kan knytte fakta til. Konsistent navn, kontaktinfo og profiler på tvers av kilder er det som gjør entiteten entydig.
- Sitering
- En sitering er når en AI-tjeneste oppgir kilden bak et svar, som regel med lenke. Sitering er noe annet enn omtale: du kan bli nevnt uten å bli lenket til, og lenket til uten å bli nevnt ved navn.
- Chunk Relevancy Ratio
- Chunk Relevancy Ratio er forholdet mellom antall tekstbiter på en side som er relevante for et gitt spørsmål, og det totale antallet biter på siden. En lang side med lav andel taper mot en kort side med høy andel, fordi språkmodeller henter biter og ikke sider.
- RAG
- RAG (Retrieval-Augmented Generation) er når en språkmodell henter inn eksterne dokumenter før den svarer, i stedet for å svare kun fra det den er trent på. Det er denne mekanismen som gjør at ferskt innhold kan siteres.
Få det jeg lærer om AI-søk
Egne tester og analyser av hvordan språkmodellene velger kilder. Ingen fast frekvens — jeg sender når jeg faktisk har noe å si.